
Этот спецпроект — точка входа в NLP для тех, кто только начинает: студентов и выпускников филологического факультета и переводческих программ; людей с гуманитарным или смешанным образованием и опытом. Мы разберемся, как устроены языковые технологии, где в них место людям, которые любят и понимают язык, и какие шаги можно сделать уже сейчас
Вы — лингвист и вам кажется, что ваш труд теряет ценность на фоне успеха больших языковых моделей? Не спешите с выводами. Хотя обработка естественного языка больше не строится на лингвистике и правилах, работа в этой области все еще есть. Лингвисты могут сделать работу ИИ точнее, этичнее и понятнее — от разметки данных до оценки качества генерации
Вы пользуетесь нейросетями, но до сих пор не понимаете, как они работают? Многие стесняются об этом спросить. «Системный Блокъ» сделал это за вас и нашел ответы
Мы не раз писали о цифровых корпусах и собраниях сочинений, исторических базах данных и интерактивных картах. Мы любим рассказывать, как они устроены и что с их помощью можно узнать. А что делать, если вы сами решили создать DH-проект? «Системный Блокъ» проанализировал удачные кейсы и составил для вас гайд.
Датасет в машинном обучении — структурированный набор данных, который используется для тренировки моделей. Чтобы обучить большую языковую модель (LLM), датасеты должны быть крупными. Сегодня посмотрим на инструмент BunkaTopics, который позволяет исследовать их — узнавать тематическую составляющую, очищать и проверять, нет ли в данных смещения.
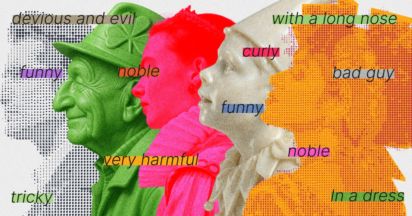
Подумайте о своем любимом книжном персонаже. Как он выглядит? что думает? как взаимодействует с другими? Мы можем описать образ героя, перечислив эти и другие черты, или проанализировать его, используя другие внутритекстовые данные. Рассказываем, как с этой задачей справятся большие языковые модели.
Иногда сложно понять, что же хотел сказать автор своим сочинением, а пересказать текст кажется нереальной задачей — из-за необычной структуры повествования или при использовании разных рассказчиков. Как справляются с подобными задачами LLM? Ученые Колумбийского университета спросили у самих писателей.
«Системный Блокъ» часто пишет о стилометрии и выпустил несколько учебных материалов (базовый, продвинутый и ещё один) о том, как провести собственное исследование с помощью библиотеки Stylo для языка R. А что делать тем, для кого Python удобнее? Рассказываем в новом тьюториале о стилометрии для англоязычных текстов, используя библиотеку Faststylometry.
В исследованиях по определению авторства и количественному анализу стиля широко используется метод Дельта филолога Джона Бёрроуза. Однако Дельта — не единственная придуманная им стилометрическая мера. Дж. Бёрроуз также является автором меры зета, с помощью которой можно сравнивать корпуса текстов. Расчёты на её основе встроены в одну из функций пакета Stylo — oppose().
«Системный Блокъ» уже рассказывал, что такое стилометрия, и как сделать её своими руками с помощью библиотеки Stylo на языке программирования R. В новом гайде мы познакомим вас с функцией rolling.classify(), которая может помочь в исследований произведений, написанных в соавторстве.
Точные методы в гуманитарных науках появились задолго до компьютеров — и в России их история перевалила уже за полтора века. Вспоминаем, как филологи, историки, лингвисты, математики и другие исследователи развивали количественные подходы к анализу литературы, языка и других гуманитарных объектов — и создавали базу для становления на российский почве Digital Humanities
Подкорпус Национального корпуса русского языка, в котором можно изучать ударения русских слов, содержит произведения поэтов-любителей с сайта Стихи.ру. Каким образом они могут быть полезны для науки — читайте в нашем материале