
Мария Подрядчикова
Автор
Использую digital humanities, чтобы сделать жизнь немного веселее. Ищу вещи в НКРЯ: https://t.me/ruscorpora_is_fun

Язык постоянно меняется — и эти изменения можно измерить. Корпусы текстов позволяют работать с языком как с данными: искать закономерности, отслеживать, как слова появляются и уходят, сравнивать тексты разных эпох и авторов. Главный инструмент для русского языка — Национальный корпус русского языка (НКРЯ). Этот проект — страница для тех, кто хочет попробовать корпусный анализ самостоятельно. Здесь вы найдете развлекательные тесты, разборы реальных исследований и практические руководства — все, что нужно, чтобы начать изучать язык через призму данных
Вот уже больше 150 лет люди шлют друг другу открытки — поздравляют, сообщают о своих делах, передают просьбы. В открытках отражается не только повседневная жизнь, но и язык эпохи, на который влияют исторические события и социальные перемены. Проанализировав множество открыток, можно проследить, какие слова исчезали и появлялись в разные периоды. Разбираемся, чем отличаются дореволюционные и советские открытки и что их язык может рассказать об истории общества

Может показаться, что технологии и чтение — вещи не очень близкие. Первые подразумевают скорость, интерфейсы и данные; второе — неспешность, страницы и погружение. Но стоит присмотреться, и граница между ними оказывается куда тоньше, чем принято думать: существуют приложения для читателей, инструменты анализа текста и даже онлайн-книжные клубы. Мы собрали материалы для тех, кто любит читать, — даже если слово «технологии» вас до сих пор немного напрягало
Многие цифровые гуманитарные методы и инструменты органично смотрятся в научно-популярных материалах и исследованиях: по ключевым словам произведений действительно можно составить их портрет, а истории про стилометрию нередко читаются как детективный роман. В этом материале автор рассказывает о собственном опыте подготовки теста «Остен или Бриджертоны» для книжного проекта «Смысловая 226», сложностях этой работы и неожиданных забавных находках
Мы не раз писали о цифровых корпусах и собраниях сочинений, исторических базах данных и интерактивных картах. Мы любим рассказывать, как они устроены и что с их помощью можно узнать. А что делать, если вы сами решили создать DH-проект? «Системный Блокъ» проанализировал удачные кейсы и составил для вас гайд.
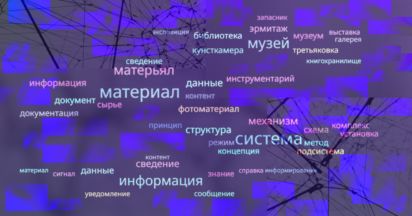
В Национальном корпусе русского языка за последние годы появилось много новых инструментов. Один из них — это «Портрет слова», который не только содержит информацию о морфологических признаках и морфемах каждого слова, но и дает представление, например, о его семантических соседях. В статье мы покажем, как пользоваться этим и другими заметными нововведениями, и расскажем, какие технологии за ними стоят.

Слова, как и люди, любят компанию. У каждого есть свой круг «общения» — другие слова, которые часто встречаются рядом с ним в схожих контекстах. Однако этот круг меняется со временем. В XIX веке у слова могли быть одни «приятели», а в XXI — совершенно другие. С помощью Национального корпуса русского языка мы можем заглянуть в прошлое и увидеть, как трансформировались эти семантические окрестности. Сможете ли вы опознать слово, зная лишь его «компанию» из разных эпох? Пройдите наш тест и проверьте свою лингвистическую интуицию!
Для того, чтобы определить степень родства двух языков, часто сравнивают их лексический состав. Рассказываем о списке Сводеша — инструменте, созданном американским лингвистом Моррисом Сводешем для сравнения языков.
В каком произведении школьной программы умирают лягушки, а в каком — скачут блохи? Пройдите наш тест на основе Национального корпуса русского языка и попробуйте отличить Гоголя от Салтыкова-Щедрина, а Лермонтова от Блока.
Историю можно изучать не только по летописям или книгам, но и по частным источникам, или эго-документам: письмам, дневникам, записным книжкам. Рассказываем об эго-документах и связанных с ними цифровых исследованиях.
Мы собрали лучшие материалы «Системного Блока», посвящённые главной цифровой коллекции текстов на русском языке: художественных, научных, церковнославянских, диалектных, списанных с бересты, поэтических, памятников литературы с XI века и многих других.
Рассказываем про вид данных, отличающийся от привычных big data, и чем малые данные похожи на археологический раскоп.
«Закатить глаза» или «троекратный поцелуй»? Узнайте, каким жестом вы были бы во вселенной мультимедийного корпуса русского языка.
Идиостиль — это авторский стиль писателя. И если на небольших стихах его изучать удобно, то вот на текстах Льва Толстого — очень непросто. Рассказываем, как филолог Борис Орехов использует векторно-семантические модели для анализа идиостиля Толстого.
Какие слова чаще встречаются в анекдотах, а какие — в деловых документах? Узнать это можно на сайте Национального корпуса русского языка, на основе которого мы придумали тест. Проверьте, насколько хорошо вы разбираетесь во всем разнообразии текстов на русском языке — от смс-сообщений до классической литературы.
15 марта 2023 года прошёл круглый стол «Digital Humanities в Центральной Азии» — серия панельных дискуссий, на которых учёные из стран Центральной Азии обсудили цифровые гуманитарные исследования и проекты в регионе. Участница Системного Блока сходила на мероприятие и рассказывает, о чем там говорилось.
Национальный корпус русского языка (НКРЯ) — важнейший инструмент любого исследователя, который занимается русским языком, русской литературой и вообще русской словесной культурой. Изменения в работе НКРЯ были заметны ещё в 2019 году: тогда лингвисты высказали опасения о возможном закрытии сервиса. К счастью, проблемы оказались временными, и НКРЯ не только не прекратил свою работу, но и заметно изменился и расширился. Самым заметным обновлением стал новый дизайн сайта, но есть и много глубоких содержательных перемен. Об основных обновлениях в корпусе, очевидных и не очень — в нашем сегодняшнем материале.
Если вы были в ТикТок, то знаете, что тренд там можно сделать из чего угодно. Пару месяцев назад сотни тысяч просмотров начали набирать записи экрана с сайта Google Books Ngram Viewer, показывающем популярность слова в определенный период времени. Пользователи находят слово «эмо» в 1803 году или упоминание «Звёздных войн» — в 1696
Как генерировать названия детективов в стиле Донцовой с помощью списка фразеологизмов, семантических векторов и морфологического анализатора